这套编制在纸面上很完整,但放到真实的报价单旁边,第一个翻车点是钱。一支六到八人的小队跑一个季度,全成本轻松过百万,而国内企业AI项目大多仍按传统软件逻辑一口价签单,合同额根本养不起满编。于是角色被悄悄兼职化,评测工程师往往是第一个被牺牲的——“上线后再补质量”几乎成了行业默认,而模型一升级效果就回退的坑,多半就是从这个缺口开始的。换句话说,缺编制的背后常常是缺毛利,先算账再组队,比按图索骥招人更接近真相。
第二个翻车点在客户侧。原文要求镜像团队“有时间、有决策权”,这在制造业和政企客户里恰恰是最稀缺的东西:真正懂流程的骨干不会为外部项目腾手,你最后拿到的常常只是“有空开会的人”。一线的判别信号很朴素——客户IT两周内连测试账号都开不出来,或者业务Sponsor连续三次派下属参会,这个项目大概率只会停在“技术可以做”。做跨境和供应链项目还有一个隐性成本高地:关务、物流、财务对同一个“异常件”的定义都不一样,数据负责人若只是挂名,你的黄金测试集从第一天起就是歪的,后面所有评测精度都是假象。
所以我的建议很具体:下一个项目立项时,把镜像团队的六个接口写进项目章程,明确每人每周投入小时数和关键决策时限(例如数据权限两周内开通、UAT按合同周期锁定),任一条落空即触发范围与排期重谈。这比上线后才发现没人签字验收,便宜太多了。
—— FDE中国编辑 · 实战派
# 一支完整的企业FDE团队,应该配置哪些角色?
来源:FDE前线 · 2026年9月2日 12:19
很多企业组建 FDE 团队时,第一反应是找几个“既懂模型、又会写代码、还能跟客户沟通”的全栈工程师。
这种配置做出 Demo 往往很快,进入生产却容易失速:业务价值没人持续确认,客户需求不断膨胀,数据接口卡在 IT 部门,模型升级后效果回退,上线后没有监控,业务人员也没有真正改变工作方式。
问题不在于工程师不够强,而在于团队把本应由多个角色承担的责任,全压在了少数“英雄型 FDE”身上。
2026 年 5 月,OpenAI 在介绍 Deployment Company 时,把 FDE 的工作概括为在企业内部设计、构建、测试并部署生产系统,连接模型与客户的数据、工具、控制机制和业务流程。工信部最新文件同样使用的是“前线部署工程师团队”,并要求其扎根用户现场、保障场景落地。
两个表述都指向同一个事实:企业 AI 交付从来不是一个人的工作。
一支完整的 FDE 团队,需要同时对业务价值、生产质量和能力复用负责。自制图。
FDE 团队没有唯一标准编制。金融、制造、零售与政务项目的人员数量不同,同一个角色在 PoC 阶段也可能由一人兼任。真正不能缺的是三类结果责任。
第一,能否把模糊问题变成值得投入的业务场景,并把范围、指标和验收方式说清楚。
第二,能否把 Agent、RAG 或工作流接入真实数据和生产系统,在权限、评测、监控、回滚与人工接管机制下稳定运行。
第三,能否推动业务人员持续使用,并把连接器、Skill、测试集、行业模板和失败经验沉淀下来,让下一次交付更快、更便宜。
如果团队只能完成第一种结果,它更像咨询团队;只能完成第二种结果,它更像项目开发团队;做完上线就撤场,则很可能重新退回人工流程。完整的 FDE 体系必须把三种结果连成一个循环。
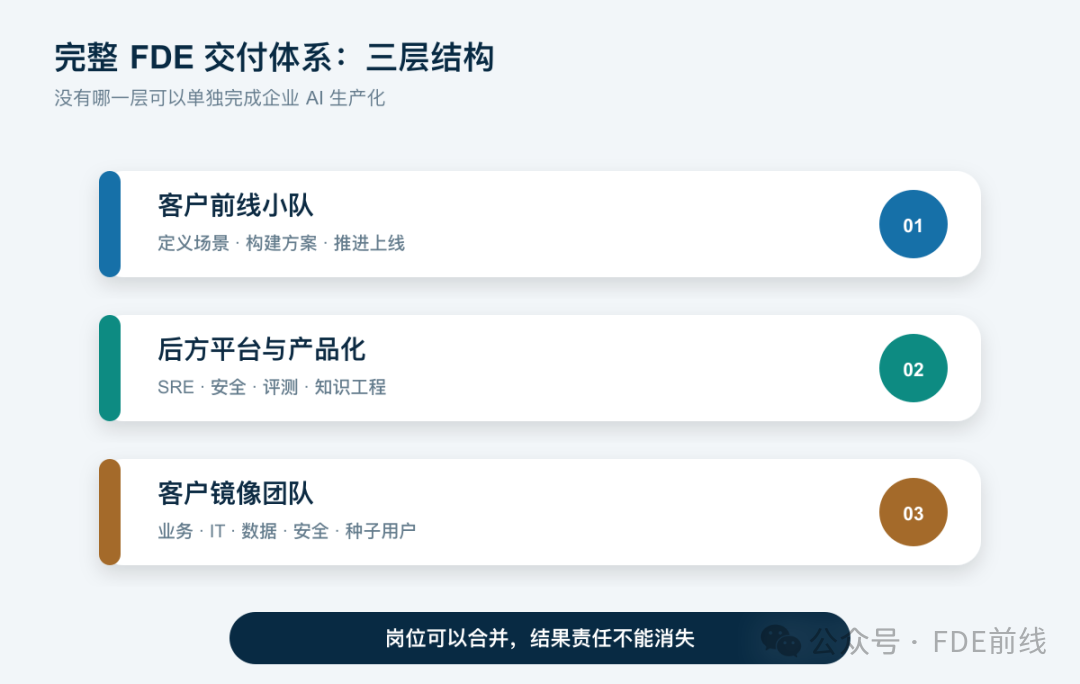
前线小队负责结果,后方平台负责复用,客户镜像团队负责组织落地。自制图。
二、前线小队:6—8人对交付结果负责
标准生产项目可以配置一支 6—8 人的前线小队。人数不是硬指标,关键是下面六类责任都要有明确负责人。
1. Echo/行业解决方案负责人
Echo 负责进入业务现场,理解客户真正如何工作,重新定义问题并识别高价值场景。核心交付物不是一份泛泛的调研报告,而是业务流程图、场景优先级、价值假设和行业对象模型。考核重点应放在场景价值、客户信任以及方案能否跨客户复用。
Echo 这一名称可以在 Palantir 当前招聘体系中看到,其 Deployment Strategist 岗位被归入 Echo,职责包括深入客户工作流、定位最重要的问题并与工程师共同交付。国内团队未必需要沿用名称,但必须有人对“做什么、为什么值得做”负责。
2. FDPM/前线部署产品经理
FDPM 把业务目标翻译为可交付范围,管理里程碑、客户预期、测试用例、验收标准和风险清单。传统产品经理往往围绕通用路线图工作,FDPM 则直接面对一个客户的真实环境,对部署结果负责,并把现场反馈送回核心产品。
这个称谓目前仍在形成中,市场上也会出现 Deployed Product Manager、Field Product Manager 等变体。无论叫什么,团队都需要一个人持续控制范围,避免每次客户反馈都变成插队需求。
3. FDE技术负责人
技术负责人连接客户架构和内部产品,对模型选择、总体架构、数据边界、集成方式与上线策略作出端到端决策。他不应成为所有代码的唯一作者,而要保证关键技术决策一致,知道哪些能力应该定制、哪些必须沉淀为平台。
4. Delta/AI应用工程师
Delta 是主要构建力量,通常配置 2—3 人,负责 Agent、RAG、工作流、Prompt、前后端与业务应用。Palantir 当前将 Forward Deployed Software Engineer 岗位归入 Delta,其职责从高层系统设计、原型开发一直覆盖应用构建和数据集成。
Delta 的考核不能只看代码量,应关注任务成功率、迭代速度、代码质量以及现场反馈能否快速转化为产品改进。
5. 数据与系统集成工程师
企业 AI 的大量时间消耗在数据库、API、ERP、CRM、身份权限和遗留系统上。这个角色负责数据管道、连接器、权限映射和接口文档,对数据质量、接口稳定性与连接器复用率负责。若项目只依赖人工复制数据,再强的 Agent 也无法进入真正的业务闭环。
6. AI评测与质量工程师
他负责黄金测试集、自动评测、回归测试、长尾错误和 A/B 测试。Anthropic 在 2026 年发布的 Agent 评测实践中强调,评测应贯穿整个生命周期:自动化测试用于发布前快速迭代,生产监控发现真实分布变化,人工审查再用于校准主观质量。
早期项目中,评测职责可以由资深 Delta 兼任,但“由谁定义成功、谁阻止质量回退”必须写进团队分工。
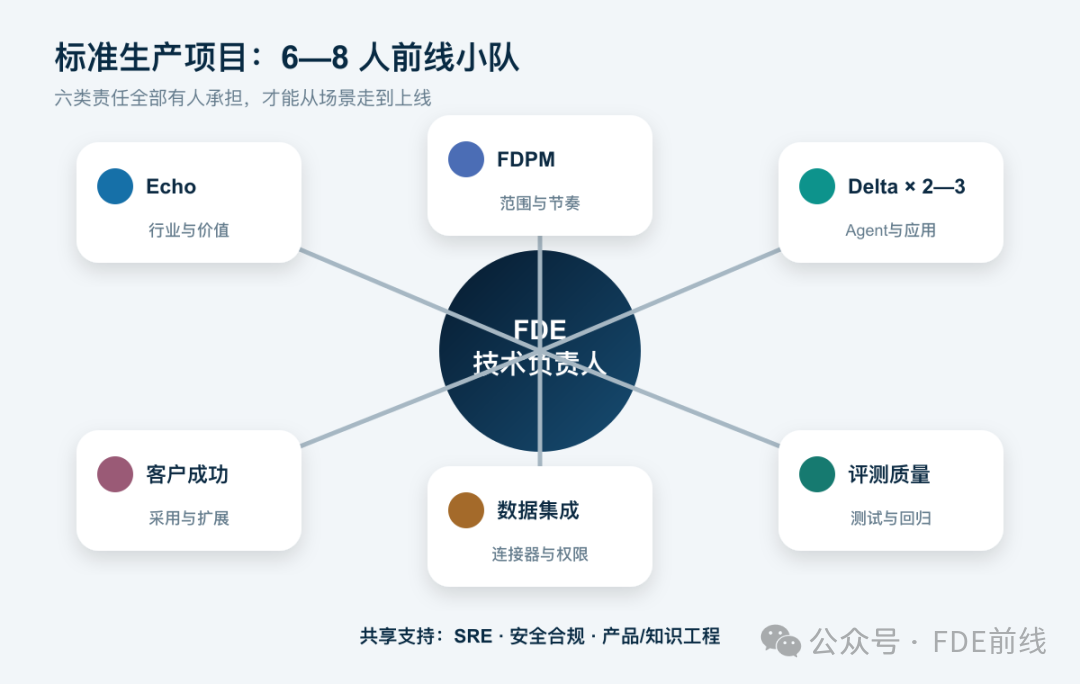
标准项目以 6—8 名全职成员为中心,平台、安全与客户成功可共享支持。自制图。
三、后方团队:决定FDE能否从项目制走向规模化
前线小队之外,还需要一支服务多个项目的后方平台与产品化团队。它们不一定每个项目全程驻场,但责任不能缺席。
平台工程/SRE负责部署、可观测性、扩缩容、成本、回滚与故障响应。Google SRE 的 Production Readiness Review 会检查架构依赖、指标监控、应急响应、容量和变更管理。对企业 Agent 来说,这些要求还要增加模型版本、Token 成本、工具调用轨迹和人工接管率。
安全与合规负责人负责数据访问、隐私、身份权限、审计、第三方模型风险与兜底边界。NIST AI RMF 要求组织明确 AI 风险责任、上线前测试、生产监控,以及申诉、覆盖、事故响应和退役机制。安全不应在上线前最后一周才进场,而要从场景设计阶段决定哪些数据能看、哪些动作能做。
客户成功/组织变革负责人负责培训、采用计划、运营数据与扩展路线图。系统上线只是起点,只有业务人员把它纳入日常流程,项目价值才会从“可用”变成“被使用”。早期这项职责可以由 FDPM 兼任,战略客户应配置专人。
产品/知识工程负责人负责把现场经验抽象为 Skill、连接器、模板、行业本体、评测集、Playbook 和失败案例库。OpenAI 当前对 FDE 管理者的要求中,明确包含把有效实践编码为工具、方法和产品路线输入。这个角色决定 FDE 是不断重复定制,还是形成越交付越快的复利。
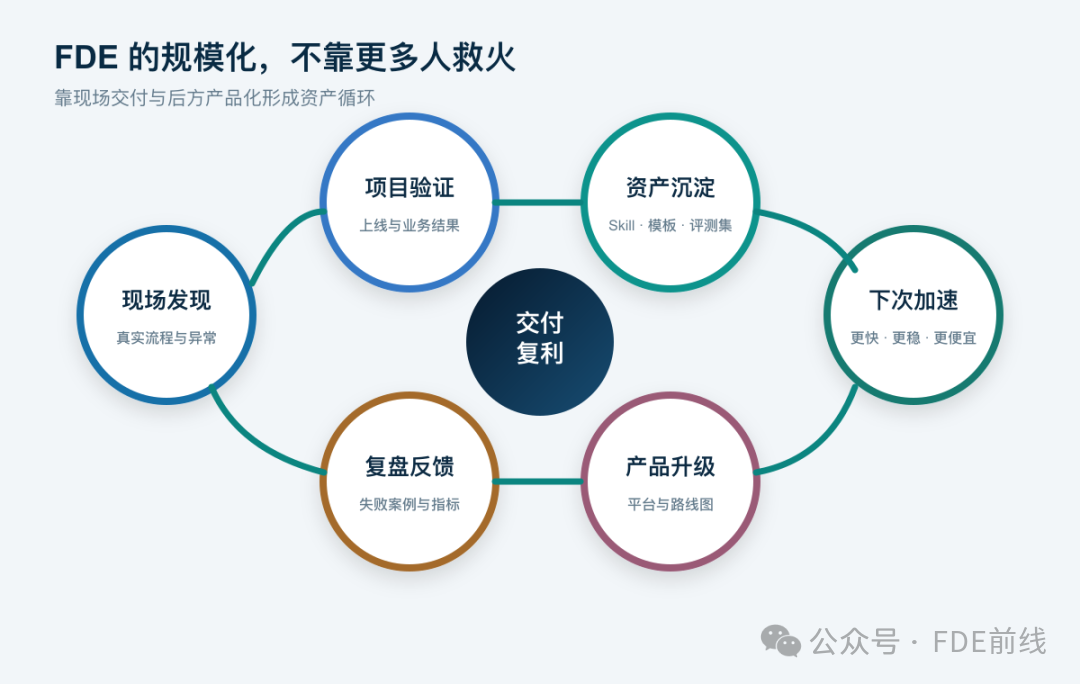
现场发现问题,项目验证能力,平台沉淀资产,资产再加速下一次交付。自制图。
四、客户侧必须建立一支“镜像团队”
供应商人员再完整,也无法单方面完成企业 AI 交付。客户至少需要六个明确接口:业务 Sponsor 确认优先级并推动跨部门协同;业务流程负责人提供真实规则和异常;IT 或架构负责人负责系统接入与上线审批;数据负责人确认口径、质量和访问权限;安全合规负责人审批日志与风险边界;一线种子用户参与试用、UAT 和后续推广。
这里最关键的不是把人名填进通讯录,而是确保他们有时间、有决策权,也愿意共同承担验收结果。
如果只有客户 IT 部门参与,业务负责人长期缺席,团队通常只能证明“技术可以做”;如果只有业务部门参与而 IT、安全没有尽早进入,项目会在演示之后卡在账号、接口和上线审批。
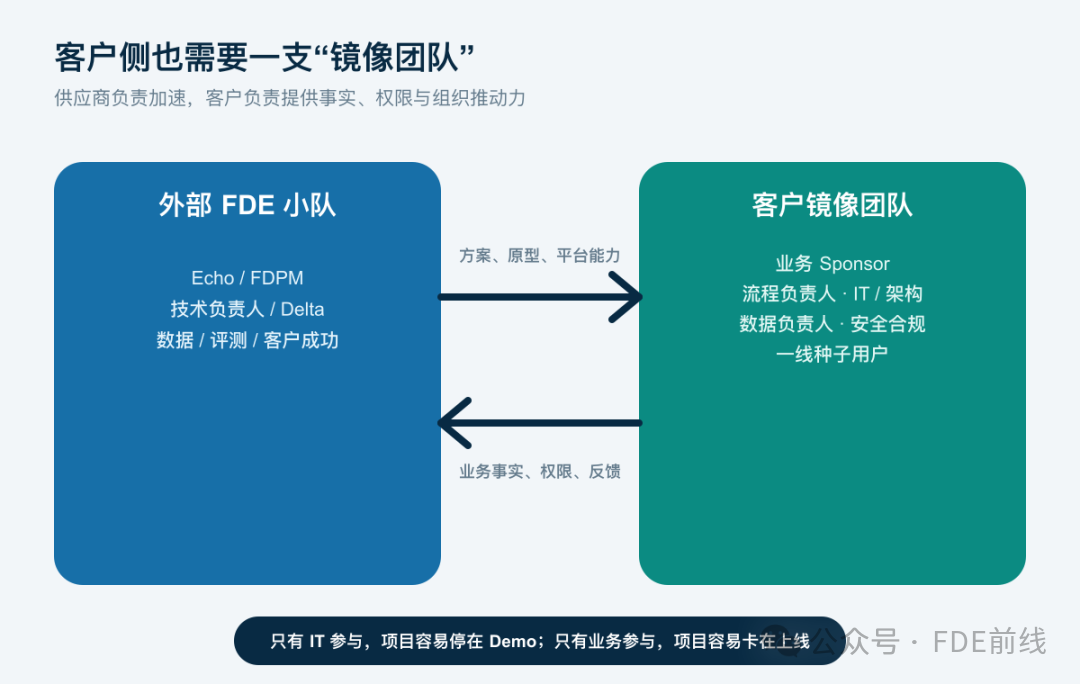
外部 FDE 与客户业务、IT、数据、安全和种子用户组成联合交付机制。自制图。
五、不同项目规模,怎样安排人数
轻量 PoC:3—4 人。 Echo 或 FDPM 负责价值与范围,一名技术负责人控制架构,一至两名 Delta 完成原型,数据、安全和平台专家按需评审。目标是验证价值和技术路径,不能把 PoC 代码直接当成生产方案。
标准生产项目:7—10 人。 配置完整前线小队,SRE、安全、客户成功与产品化角色由后方共享。这是单部门、单核心流程比较稳妥的形态。
战略客户或复杂行业:10—15 人以上。 Echo 与 FDPM 应分别专职,Delta 按 Agent、应用、集成等方向分工,评测、安全、SRE 和客户成功独立配置,同时设置项目总监和高层 Sponsor。金融、制造、医疗、政务以及多供应商项目尤其需要内部技术锚点,确保核心架构、资产和责任始终有人掌握。
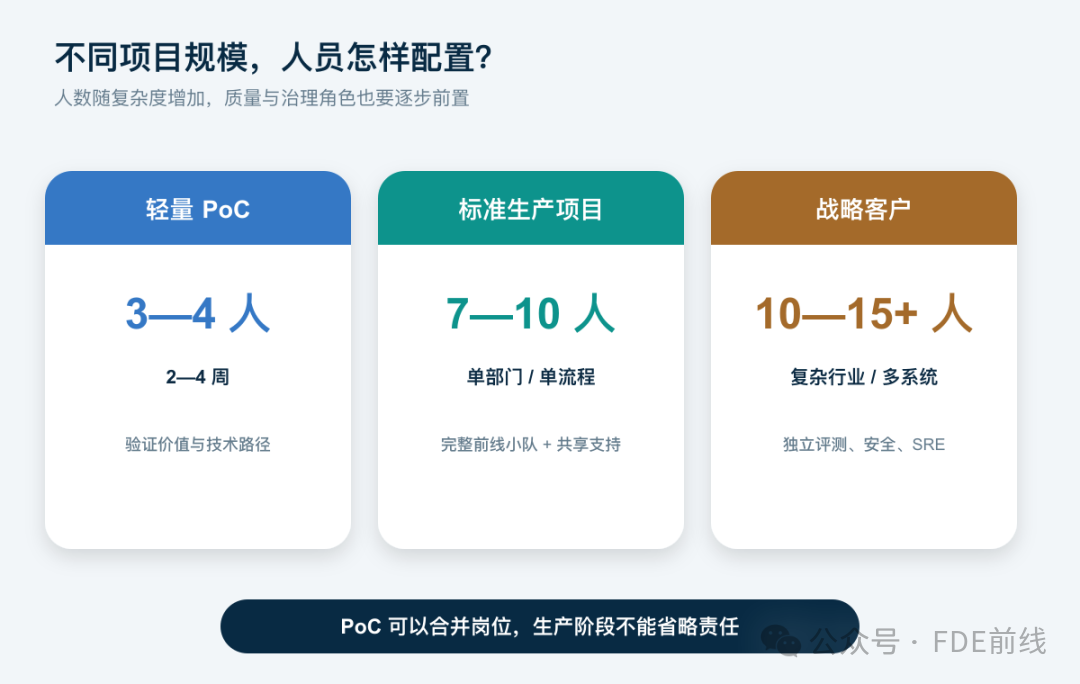
岗位可以合并,责任不能消失;项目越接近生产,质量和治理角色越需要前置。自制图。
六、别只考核“按时上线”
FDE 团队的指标至少要覆盖四组结果。
客户价值包括任务完成率、处理时长、成本变化、用户使用率和满意度;工程质量包括评测覆盖率、系统可用性、故障恢复时间、权限控制和人工接管能力;资产沉淀包括 Skill 与模板产出、连接器复用次数、跨项目节省工时和反馈采纳率;商业结果包括从 Land 到 Expand 的周期、续费率、场景扩展率、单客户交付成本和项目毛利。
早期团队可以把工程师大部分精力放在交付,但必须预留稳定的资产沉淀时间。随着团队成熟,复用指标的权重应逐步提高。否则项目越多,高手越忙,交付成本反而越高。
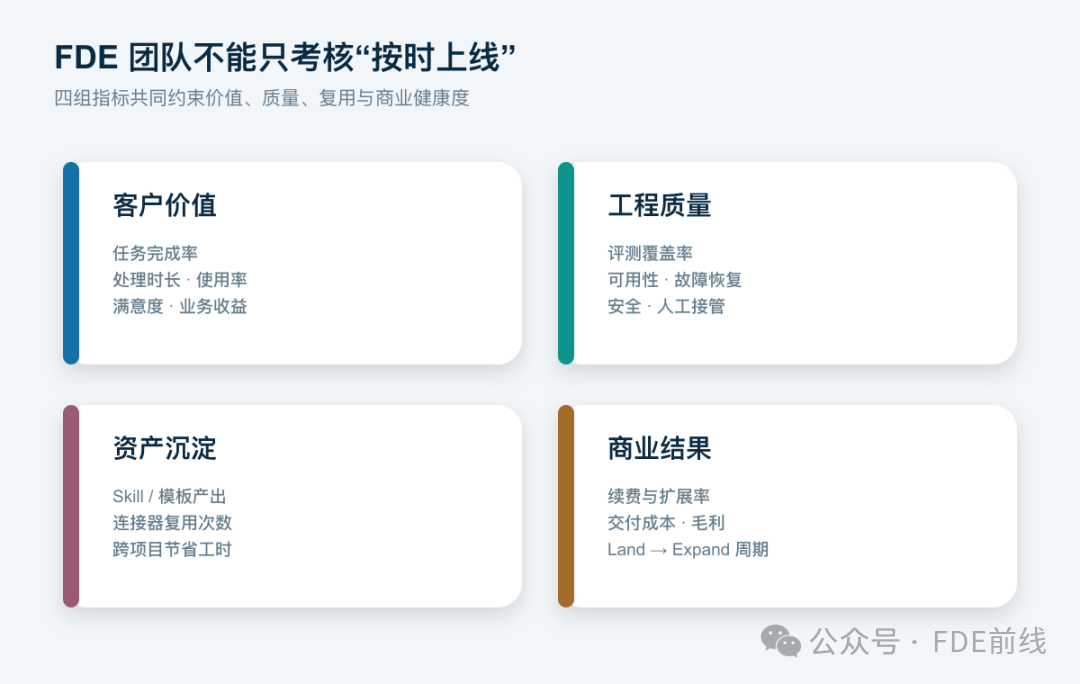
同时衡量价值、质量、复用与商业结果,才能避免FDE退化为免费售前或定制外包。自制图。
最后:最小的完整配置是什么
如果把这套团队压缩成一句话:1 名 Echo 定义问题,1 名 FDPM 推动范围与组织,1 名技术负责人控制架构,2—3 名 Delta 完成构建,数据与评测角色保证输入和质量;SRE、安全、客户成功、产品与知识工程在关键节点进入,客户侧再提供一支拥有决策权的镜像团队。
PoC 阶段可以把最小核心压缩为 Echo、FDPM、资深 Delta 与产品/知识工程四类责任,由少数人兼任。但进入生产后,数据集成、评测、SRE、安全和客户成功必须补齐。
判断一支 FDE 团队是否真正完整,可以连续问三个问题:它能否把模糊业务问题推进到生产上线?能否让业务人员真正使用并产生量化价值?能否让下一次同类交付明显更快、更便宜?
只做到第一项,是一支项目交付团队。三项都能做到,才是一支真正的企业 FDE 团队。
如果你正在搭建 FDE 团队,欢迎关注「FDE前线」。我们会继续拆解岗位分工、交付流程、评测体系和企业 AI 生产化方法。
参考资料
• OpenAI launches the OpenAI Deployment Company[1]
• OpenAI:Manager, Forward Deployed Engineering[2]
• Palantir:Deployment Strategist[3]
• Palantir:Forward Deployed Software Engineer[4]
• Anthropic:Demystifying evals for AI agents[5]
• Google SRE:Production Readiness Review[6]
• NIST AI Risk Management Framework[7]
• 工信部办公厅关于开展人工智能应用服务商培育专项行动的通知[8]
引用链接
[1] OpenAI launches the OpenAI Deployment Company: https://openai.com/index/openai-launches-the-deployment-company/
[2] OpenAI:Manager, Forward Deployed Engineering: https://openai.com/careers/manager-forward-deployed-engineering-new-york-city/
[3] Palantir:Deployment Strategist: https://jobs.lever.co/palantir/e0ab8226-b928-4e3a-bf87-08fe7b1ea595
[4] Palantir:Forward Deployed Software Engineer: https://jobs.lever.co/palantir/1bb19522-3936-4adc-9ced-c3df8b5900b9
[5] Anthropic:Demystifying evals for AI agents: https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents
[6] Google SRE:Production Readiness Review: https://sre.google/sre-book/evolving-sre-engagement-model/
[7] NIST AI Risk Management Framework: https://airc.nist.gov/airmf-resources/airmf/5-sec-core/
[8] 工信部办公厅关于开展人工智能应用服务商培育专项行动的通知: https://www.miit.gov.cn/zwgk/zcwj/wjfb/tz/art/2026/art_6fbc038bf15c445ab53b2a94a3f9d4e4.html